Совет «закройте сайт от ИИ-ботов» слишком грубый, чтобы быть полезным. Под одним ярлыком работают разные механизмы: поисковый робот собирает страницы для ответов со ссылками, тренировочный краулер — материал для будущих моделей, пользовательский агент открывает адрес по просьбе человека, рекламный бот проверяет лендинг. Одной общей блокировкой можно защитить ценный архив — или незаметно исключить публичный бизнес из ответов, где потенциальный клиент сравнивает поставщиков.
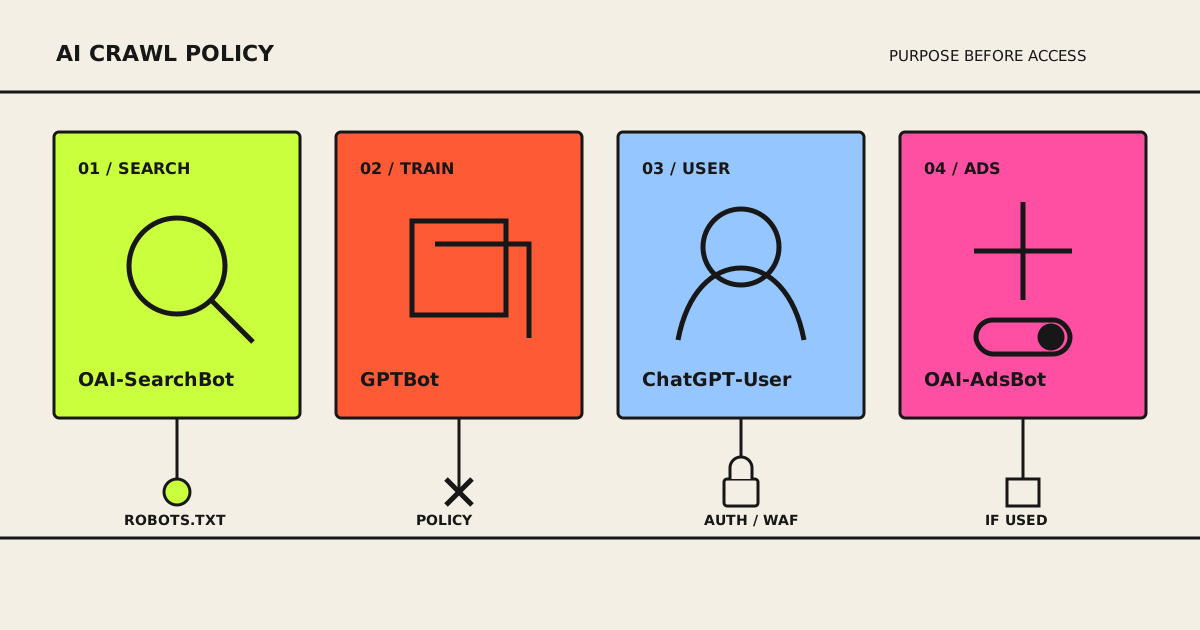
Разумная отправная точка для открытого сайта услуг или интернет-магазина: пропускать проверенных поисковых ботов, отдельно решить вопрос обучения моделей, давать пользовательским агентам только публичный контент, а личные кабинеты и внутренние данные закрывать настоящей авторизацией. Названия ботов и правила платформ меняются, поэтому это каркас политики, а не вечный фрагмент кода.
Почему решение нельзя откладывать до следующего SEO-аудита
Ассистенты уже участвуют в выборе задолго до оплаты. В опросе жителей Франции, Германии и Великобритании, проведённом в декабре 2025 года, 38% респондентов McKinsey использовали ИИ при поиске товаров и услуг или принятии решения о покупке. Переносить эту цифру на выручку отдельной компании нельзя. Но технический доступ к публичным страницам теперь связан не только с нагрузкой и правами на контент, но и с привлечением клиентов.
Платформы, в свою очередь, ввели более точные элементы управления. OpenAI документирует разные агенты для поиска ChatGPT, возможного обучения базовых моделей, действий пользователя и проверки рекламной страницы. У Anthropic разделены обучение, поиск и открытие сайта по пользовательскому запросу. Perplexity отличает индексатор от user-triggered доступа. Google использует Googlebot для Search и отдельный продуктовый токен Google-Extended для некоторых сценариев Gemini.
Поэтому выбор шире, чем «разрешить всё» или «запретить всё». Магазину могут быть нужны ссылки из AI-поиска, но не обучение на его редакционных материалах. SaaS-компания может открыть публичную документацию и закрыть примеры для клиентов. Медиа может индексировать анонсы, оставив полный текст за подпиской.
Сначала разделите ботов по задаче
| Задача | Что она даёт | Чем управлять |
|---|---|---|
| Поиск и цитирование | Публичная страница может попасть в ответ со ссылкой | robots.txt, карта сайта, доступный HTML, WAF |
| Обучение моделей | Контент может использоваться для будущих базовых моделей | Специальный токен провайдера, лицензия и договорная позиция |
| Действие пользователя | Ассистент открывает URL, который попросил прочитать человек | Авторизация и WAF; robots.txt действует не у всех одинаково |
| Проверка рекламы | Платформа проверяет отправленный в рекламу лендинг | Разрешение для используемого продукта плюс проверка IP |
На 20 августа 2026 года OpenAI описывает четыре роли. OAI-SearchBot нужен для поиска ChatGPT. GPTBot собирает контент, который может попасть в обучение базовых моделей. ChatGPT-User обращается к страницам в рамках отдельных действий человека. OAI-AdsBot проверяет лендинги, поданные в рекламу ChatGPT. Настройки независимы: запрет для GPTBot не требует закрывать OAI-SearchBot.
У Anthropic аналогичное разделение выражено через ClaudeBot, Claude-SearchBot и Claude-User. Perplexity указывает, что PerplexityBot работает для поисковой выдачи и не собирает данные для обучения базовых моделей, а Perplexity-User выполняет запрос человека и обычно не следует robots.txt как плановый краулер. Копировать старый список user-agent без ссылки на официальную документацию опасно: смысл и идентификаторы меняются.
Решение принимают для зоны контента, а не для логотипа платформы
Разбейте сайт на публичные услуги, товары и категории, статьи, открытую документацию, лицензионные или платные материалы, пользовательские публикации, личный кабинет, checkout, админку, партнёрский портал, staging и внутренние API. После этого определите желаемый результат для каждой зоны.
| Контент | Стартовая позиция | Логика |
|---|---|---|
| Открытые товары и услуги | Разрешить проверенный поиск; обучение решить отдельно | Точная рекомендация может привести подходящего клиента |
| Статьи и публичная база знаний | Открыть поиск; для обучения выбрать разрешение, запрет или лицензию | Обнаружение и повторное использование имеют разную ценность |
| Подписка и лицензируемый архив | Отдавать предусмотренный анонс, остальное защищать на origin или edge | robots.txt не является paywall |
| Кабинет, оплата, админка, закрытые API | Требовать авторизацию и минимизировать доступ роботов | Безопасность важнее поисковой видимости |
| Staging и черновики | Авторизация и отсутствие публичных ссылок | Disallow публикует имя пути, но не защищает его |
На мультиязычном сайте проверьте каждую локаль. Если англоязычный маршрут отдаёт 200, а русскоязычный получает challenge от WAF или неправильный canonical, формально «разрешённый бот» всё равно не увидит нужную версию. Статус, серверный текст, hreflang, canonical и карта сайта должны согласовываться.
С Google есть принципиальный нюанс. Google-Extended — продуктовый токен управления, а не отдельная строка user-agent в HTTP-запросе. По данным Google, запрет этого токена не влияет на включение сайта в Google Search и не является сигналом ранжирования. Доступом обычного и генеративного поиска Google по-прежнему управляет Googlebot.
Базовый robots.txt для публичного бизнеса
Пример ниже оставляет открытые страницы доступными для поисковых систем, запрещает три документированных тренировочных сценария и указывает sitemap. Пути условны. Перед публикацией замените их, проверьте текущий файл и порядок сопоставления групп — специфическая группа может повести себя не так, как общий блок.
User-agent: *
Disallow: /account/
Disallow: /admin/
Disallow: /internal/

# Отказываемся от документированных сценариев обучения
User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: Google-Extended
Disallow: /

Sitemap: https://www.example.com/sitemap.xml
Почему здесь нет отдельных Allow для поисковых AI-ботов? Если для них не создан специальный запрет, они применяют политику публичной части. Чем меньше исключений, тем ниже риск, что специфическое Allow: / однажды откроет путь, запрещённый в общей группе. Но при автоматической блокировке ботов на CDN или WAF нужным поисковым роботам понадобится отдельное разрешение с проверкой подлинности.
Стандарт RFC 9309 подчёркивает, что robots.txt не является механизмом авторизации. Он просит добросовестного робота не заходить по адресу, но не закрывает адрес. Для данных клиентов, личных кабинетов, внутренних документов и платного архива используйте сессии, права, HTTP authentication, сетевые ограничения или равноценную защиту.
Есть и обратная ловушка: запрет сканирования не обязательно удаляет URL из результатов. Адрес могут обнаружить по внешней ссылке и показать без содержимого. Если открытую страницу нужно исключить из индекса, используйте поддерживаемый noindex или процедуру удаления, не мешая роботу сначала прочитать директиву.
Проверяйте ответ на edge, а не файл в исходниках
Между репозиторием и ботом стоят CDN, managed robots, WAF, rate limiting, плагины безопасности, reverse proxy и географические правила. Любой из них может подменить /robots.txt, вернуть challenge или 403. Например, Cloudflare AI Crawl Control позволяет управлять отдельными категориями краулеров, показывает запросы и нарушения robots.txt, а блокировки реализует правилами WAF.
- Получите живой
/robots.txtс каждого домена и поддомена извне инфраструктуры. - Запросите несколько публичных страниц с user-agent выбранного бота; затем сверьте IP с официальным диапазоном, прежде чем создавать allow rule.
- Проверьте HTTP-статус, цепочку редиректов, canonical,
hreflang, sitemap, indexability и текст в исходном HTML. - Убедитесь, что ресурсы, необходимые для понимания страницы, не блокируются соседним правилом.
- Сопоставьте edge- и origin-логи по статусам 200, 301, 403, 429 и 5xx.
Строку user-agent может написать любой скрипт. OpenAI и Perplexity публикуют актуальные диапазоны IP, Google документирует проверку своих роботов, а сервисы bot management поддерживают verified-bot категории. Не делайте широкий обход firewall для всех запросов, которые лишь представились известным ботом.
Разрешить краулинг — не значит попасть в ответы
Доступ даёт только техническую возможность обнаружения. Странице всё равно нужны стабильный URL, обычные ссылки, видимый текст, корректный canonical, актуальные факты, понятная структура, достоверные источники и структурированные данные, совпадающие с тем, что видит человек.
Google в руководстве мая 2026 года отдельно разобрал популярные GEO-мифы. Компания говорит, что llms.txt не используется для видимости и ранжирования в Google Search, специальной AI-схемы schema.org нет, дробить текст на искусственные «чанки» не требуется, а фундаментальные практики SEO остаются актуальными. Файл llms.txt можно поддерживать для конкретной системы или документационного процесса, но не следует обещать его как способ попасть в ответы.
Для интерактивного сайта важна и доступность. Семантические кнопки, подписи, состояния, заголовки, формы и ясные сообщения об ошибках улучшают работу людей с assistive technology и помогают браузерным агентам читать accessibility tree. Это качественная разработка, а не трюк для поискового робота.
После релиза считайте ценность, а не только запросы
Разделяйте визиты бота, переходы из AI-сервиса и косвенное влияние рекомендации. Первый показатель виден в серверном логе, второй — в источнике сессии, третий часто остаётся без клика и оценивается лишь приблизительно. Скачанная страница ещё не стала лидом.
Для инфраструктуры отслеживайте проверенного бота, зону, действие allow/block, статус, объём и стоимость. Для бизнеса — landing page, целевое действие, заявку или заказ, маржу и повторную покупку. OpenAI указывает, что реферальные ссылки из поиска ChatGPT получают utm_source=chatgpt.com. Это хороший наблюдаемый сигнал, но не полная картина влияния.
Небольшой компании достаточно пересматривать политику раз в квартал и вне графика после миграции CDN, изменения bot protection, запуска paywall или рекламы, обновления документации провайдера либо инцидента. Храните версию решения, владельца и способ быстрого отката.
Семидневный аудит без большого проекта
Итогом должна стать короткая таблица: зона контента, желаемый результат, бот или продуктовый токен, технический слой контроля, способ проверки, владелец, дата согласования и следующего пересмотра. Код легко переписать; сохранённая логика не даст случайно отменить решение через полгода.
Ограничения подхода
Добросовестные провайдеры могут поменять IP, названия и поведение. Пользовательские агенты не всегда следуют правилам планового краулинга. Неизвестный скрейпер может полностью игнорировать robots.txt. Разрешение не гарантирует цитату, а новый запрет не удаляет уже собранные копии или данные, полученные по другому соглашению.
Это техническая и коммерческая схема решения, а не юридическое заключение об авторском праве, text and data mining, персональных данных или лицензии. Если контент имеет существенную стоимость, согласуйте технические сигналы с договорами и профильным юристом.
Частые вопросы
Нужно ли блокировать GPTBot?
Это зависит от прав и ценности контента. Disallow для GPTBot означает отказ от будущего использования собранных материалов в обучении базовых моделей OpenAI. Поиск ChatGPT управляется отдельно через OAI-SearchBot.
Повредит ли SEO блокировка тренировочных ботов?
Не обязательно: OpenAI, Anthropic и Google разделяют поиск и обучение. Google прямо указывает, что Google-Extended не влияет на включение и позиции в Google Search. Однако общее правило WAF может случайно заблокировать и поисковых ботов, поэтому проверяйте production.
Нужен ли llms.txt, чтобы попасть в ChatGPT или AI-выдачу Google?
Нет гарантии включения в ChatGPT через llms.txt, а Google заявляет, что не использует этот файл для видимости или ранжирования Search. Поддерживайте его только для сервиса, который документирует конкретное применение.
Защищает ли robots.txt закрытый и платный контент?
Нет. Это добровольная инструкция для роботов, а не контроль доступа. Кабинеты, архивы, staging и внутренние файлы требуют авторизации или эквивалентной защиты.
Как проверить, что бот настоящий?
Сверьте адрес запроса с актуальным официальным диапазоном провайдера или доверенным verified-bot сигналом. Одной строки user-agent недостаточно.
Хорошая политика точна и проверяема
Вместо общего разрешения или запрета зафиксируйте простую матрицу: что должно участвовать в поиске, что допустимо для обучения, что можно получить по запросу человека, что всегда требует авторизации и каким тестом подтверждается реальная настройка.
Rendframe может провести технический аудит и внедрить согласованную политику: проверить живой robots.txt, CDN и WAF, server rendering, structured data, доступность, canonical и hreflang, журналы запросов и измерение конверсий. Это входит в нашу продуктовую разработку и подготовку ecommerce к агентной коммерции. Пришлите домены и список зон, которые нужно проверить.
Дальше: оцените магазин по чек-листу готовности к AI-покупателям, затем настройте атрибуцию трафика и продаж из AI-каналов.
Источники и дата проверки
Проверено 20 августа 2026 года по официальной документации краулеров OpenAI и FAQ для издателей; правилам Anthropic и Perplexity; руководству Google по генеративному поиску и справке о Google-Extended; Cloudflare AI Crawl Control; стандарта RFC 9309; и исследования McKinsey о выборе товаров с ИИ. Перед публикацией правил перепроверьте текущие идентификаторы и требования провайдеров.