У налаштуваннях хостингу легко побачити перемикач «блокувати AI-ботів» і сприйняти його як просте питання приватності. Насправді за однією назвою ховаються різні процеси: бот може збирати сторінки для пошуку, дані для майбутнього навчання моделі, відкривати посилання на прохання користувача або перевіряти рекламний лендинг. Заблокувавши все, бізнес іноді захищає потрібний контент — а іноді сам прибирає себе з відповідей ChatGPT, Claude чи Perplexity.
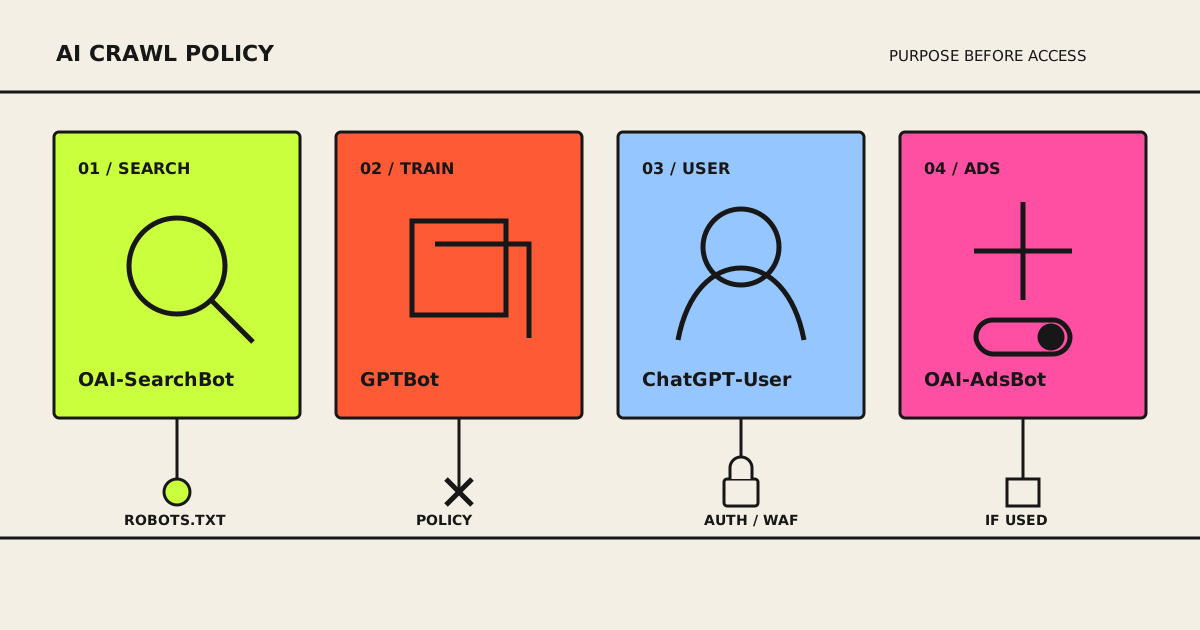
Для публічного сайту послуг або інтернет-магазину доречна така базова позиція: перевірених пошукових ботів пропускати, навчання моделей вирішувати окремо, доступ за запитом користувача дозволяти лише до справді публічних сторінок, а кабінети й внутрішні дані захищати авторизацією. Це не універсальний рецепт, а рамка для власного рішення.
Чому robots.txt уже впливає не лише на технічне SEO
AI-сервіси дедалі частіше з’являються на етапі вибору. У грудневому дослідженні 2025 року серед споживачів Франції, Німеччини та Великої Британії 38% опитаних McKinsey використовували ШІ для пошуку товарів і послуг або ухвалення рішення про купівлю. Це не прогноз для конкретного магазину й не частка продажів. Але видимість в AI-пошуку вже варто розглядати разом із Google, партнерськими каналами та маркетплейсами.
Водночас самі платформи розділили функції ботів. У OpenAI є окремі агенти для пошуку ChatGPT, потенційного навчання моделей, дій користувача та перевірки сторінок реклами. Anthropic відокремлює розробку моделей від пошуку й відкриття сторінки за запитом людини. Perplexity має окремі ідентифікатори для індексації та користувацького запиту. Googlebot відповідає за Google Search, а токен Google-Extended керує частиною сценаріїв Gemini.
Отже, реальне питання звучить не «пускати ШІ чи ні», а точніше: який контент, для якої мети, якому перевіреному боту й на якому рівні дозволяти.
Чотири ролі, які не можна змішувати
| Роль | Що отримує бізнес | Де керувати |
|---|---|---|
| Пошук і цитування | Публічні сторінки можуть потрапити у відповідь із посиланням | robots.txt, sitemap, доступний HTML, правила WAF |
| Навчання моделі | Матеріали можуть використати для майбутніх базових моделей | Окремий токен провайдера, ліцензійна й договірна політика |
| Запит користувача | Асистент відкриває конкретну сторінку, бо людина попросила | Авторизація та WAF; ставлення до robots.txt відрізняється |
| Перевірка реклами | Платформа перевіряє поданий рекламний лендинг | Дозвіл лише для потрібного рекламного продукту й офіційних IP |
У поточній документації OpenAI OAI-SearchBot відповідає за появу сайтів у пошуку ChatGPT, GPTBot — за матеріали, які можуть піти на навчання базових моделей, ChatGPT-User — за окремі дії користувача, а OAI-AdsBot — за перевірку рекламних сторінок. Налаштування незалежні: можна заборонити GPTBot і не закривати OAI-SearchBot.
Anthropic описує три відповідні ролі: ClaudeBot, Claude-SearchBot і Claude-User. Perplexity прямо зазначає, що PerplexityBot потрібен для пошукових результатів, а Perplexity-User виконує дію людини й зазвичай не дотримується robots.txt так, як плановий краулер. Саме тому список назв із випадкового блогу не можна вважати політикою: джерелом правди має бути актуальна сторінка провайдера.
Спершу розкладіть сайт на зони
Одна політика для всього домену майже завжди надто груба. Окремо опишіть сторінки послуг, картки й категорії товарів, блог, відкриту базу знань, платні матеріали, користувацькі публікації, особистий кабінет, checkout, адмінку, партнерський портал, staging і внутрішні API. Для кожної зони зафіксуйте бажаний результат.
| Зона | Базова позиція | Навіщо |
|---|---|---|
| Публічні послуги й товари | Дозволити перевірений AI-пошук; навчання вирішити окремо | Цитування може привести релевантного клієнта |
| Власні статті й документація | Відкрити пошук; для навчання обрати дозвіл, заборону або ліцензію | Знаходження матеріалу й повторне використання — різні цінності |
| Підписка або ліцензійний контент | Віддати лише запланований preview, решту закрити на origin/edge | robots.txt не замінює paywall |
| Кабінет, оплата, адмінка, приватні API | Обов’язкова авторизація; мінімальний доступ ботів | Безпека й приватність важливіші за видимість |
| Staging і неопубліковані матеріали | Авторизація, відсутність публічних посилань | Рядок Disallow показує шлях, але не захищає його |
Для українського бізнесу з кількома мовними версіями є додаткова перевірка: бот має отримувати правильний canonical, hreflang, видимий текст і статус 200 на кожному потрібному маршруті. Дозволити головну англійську сторінку, але випадково заблокувати /uk/, — це не локалізаційна стратегія, а технічна помилка.
Google потребує окремої уваги. Google-Extended не є самостійним HTTP user-agent: це токен керування для зазначених сценаріїв Gemini. Google стверджує, що його блокування не впливає на індексацію або позиції в Google Search. Для звичайного й генеративного пошуку Google вирішальним залишається доступ Googlebot.
Практичний шаблон robots.txt
Нижче — стартовий варіант для публічного сайту, який хоче залишитися доступним для пошуку, але поки відмовляється від трьох задокументованих сценаріїв навчання. Приватні шляхи тут умовні. Замініть їх своїми, перевірте наявні групи й не копіюйте приклад поверх робочого файла без тесту.
User-agent: *
Disallow: /account/
Disallow: /admin/
Disallow: /internal/

# Не дозволяємо задокументовані сценарії навчання
User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: Google-Extended
Disallow: /

Sitemap: https://www.example.com/sitemap.xml
Пошукові AI-боти не перелічені окремо: за відсутності спеціальної заборони вони успадковують правила для публічної частини. Це зменшує ризик, що окрема група Allow: / випадково обійде майбутню заборону для приватного шляху. Але якщо CDN або WAF автоматично відсікає роботів, для потрібних пошукових ботів знадобиться окреме правило з перевіреною ідентичністю.
RFC 9309 прямо каже: Robots Exclusion Protocol не є авторизацією. Для персональних даних, чернеток, кабінетів і платних матеріалів потрібні сесії, права доступу, HTTP authentication, мережеві обмеження або інший реальний захист. Так само Disallow не дорівнює видаленню з пошуку: URL можуть знайти через зовнішнє посилання. Для публічної сторінки, яку треба прибрати з індексу, застосовуйте підтримуваний noindex чи інструмент видалення, залишивши боту можливість прочитати директиву.
Перевіряйте те, що віддає production, а не лише репозиторій
Файл у Git може бути правильним, але на edge користувач і бот отримають інше. Managed robots, захист від ботів, правила WAF, rate limit, security-плагін, геофільтр або reverse proxy здатні підмінити відповідь чи повернути 403. У Cloudflare AI Crawl Control, наприклад, можна окремо дозволяти або блокувати категорії ботів, а відповідні заборони реалізуються через WAF.
- Відкрийте живий
/robots.txtна основному домені й кожному піддомені. - Запитайте типові публічні сторінки з user-agent потрібного бота, але довіряйте йому лише після звірки IP з офіційним діапазоном.
- Перевірте статус, redirect, canonical,
hreflang, sitemap, indexability і текст у серверному HTML. - Переконайтеся, що потрібні CSS, JavaScript, зображення та публічні API не відсікаються іншим правилом.
- Подивіться edge- й origin-логи: 200, 301, 403, 429 і 5xx швидко покажуть розрив між задумом і реальною поведінкою.
Рядок user-agent легко підробити. OpenAI й Perplexity публікують IP-діапазони, Google описує перевірку своїх ботів, а платформи bot management мають категорії verified bots. Для firewall використовуйте поєднання офіційного діапазону та ідентифікатора, а не широке правило «дозволити всім, хто назвався GPTBot».
Доступ до сканування не гарантує відповіді ChatGPT
Дозвіл лише робить сторінку технічно придатною до знаходження. Далі потрібні стабільна URL-адреса, доступні внутрішні посилання, видимий текст, коректний canonical, актуальні факти, зрозумілі заголовки, доречні структуровані дані й докази, яким можна довіряти.
У травні 2026 року Google окремо розібрав популярні міфи про генеративний пошук. Компанія заявляє, що llms.txt не допомагає видимості або позиціям у Google Search, спеціальної AI-розмітки schema.org не існує, а штучно дробити текст на дрібні блоки не потрібно. Якісне технічне SEO й корисний оригінальний матеріал залишаються основою.
Доступність інтерфейсу теж має подвійний ефект. Семантичні кнопки, підписи полів, стани, заголовки, зрозумілі помилки й клавіатурна навігація потрібні людям, але водночас допомагають браузерним агентам читати accessibility tree. Це не GEO-хак, а нормальна якість продукту.
Що вимірювати після зміни
Не змішуйте три рівні. Активність ботів — запити до сервера. AI-переходи — сесії з упізнаним джерелом. AI-вплив — рекомендації без прямого кліка, які доводиться оцінювати непрямо. Сканування не є лідами, а згадка не є продажем.
У логах дивіться на перевіреного бота, дозволену або заблоковану дію, зону контенту, статус, обсяг і вартість інфраструктури. У бізнес-аналітиці — на landing page, цільову дію, заявку чи замовлення, маржу й повторну покупку. OpenAI зазначає, що посилання з пошуку ChatGPT містять utm_source=chatgpt.com; це корисний спостережуваний сигнал, але він не покаже рекомендацію без переходу.
Для невеликого сайту достатньо щоквартального перегляду політики. Позапланово поверніться до неї після міграції CDN, зміни bot protection, запуску paywall або реклами, оновлення документації провайдера чи інциденту.
Аудит політики за сім днів
Підсумок зручно тримати в одній таблиці: зона контенту, бажаний результат, назва бота або продуктового токена, рівень контролю, спосіб перевірки, відповідальний, дата погодження й наступного огляду. Код короткий; логіка рішення має пережити зміну команди й платформи.
Чого ця політика не гарантує
Провайдери змінюють назви, IP, продукти й правила. Частина user-triggered агентів поводиться не так, як планові краулери. Невідомий скрейпер може повністю ігнорувати robots.txt. Дозвіл не гарантує цитування, а нова заборона не видаляє вже отримані копії.
Це технічна й комерційна рамка, а не юридичний висновок щодо авторського права, винятків text and data mining, персональних даних або ліцензії. Для цінного контенту узгодьте сигнали з договорами та профільним юристом.
Поширені запитання
Чи варто блокувати GPTBot?
Вирішуйте за цінністю й правами на контент. Заборона для GPTBot сигналізує, що майбутні матеріали не слід використовувати для навчання базових моделей OpenAI. Для пошуку ChatGPT існує окремий OAI-SearchBot.
Чи зашкодить SEO блокування ботів навчання?
Не обов’язково: OpenAI, Anthropic і Google розділяють пошук та навчання. Google прямо пише, що Google-Extended не впливає на присутність і ранжування в Google Search. Але грубе правило WAF може ненавмисно зачепити й пошукових ботів, тому production треба тестувати.
Чи потрібен llms.txt, щоб потрапити у відповіді ChatGPT або Google AI?
Немає гарантії, що llms.txt забезпечить включення до ChatGPT, а Google не використовує його для видимості чи позицій у Search. Підтримуйте файл лише заради конкретної системи, яка документує його застосування.
Чи захищає robots.txt платний або приватний контент?
Ні. Це добровільний протокол для роботів, а не контроль доступу. Кабінети, платні матеріали, staging і внутрішні файли потребують авторизації або рівноцінного захисту.
Як відрізнити справжнього AI-бота?
Зіставте IP з актуальним офіційним діапазоном провайдера або verified-bot сигналом. Однієї назви в user-agent недостатньо.
Добра політика проста, але не сліпа
Замість «усі AI-боти дозволені» чи «всіх заблокувати» потрібна маленька матриця: що має знаходитися в пошуку, що можна використовувати для навчання, що дозволено відкрити за запитом людини, що завжди вимагає авторизації та як production підтверджує це рішення.
Rendframe може перевірити й налаштувати весь технічний ланцюг: живий robots.txt, CDN і WAF, server rendering, структуровані дані, доступність, canonical і hreflang для мовних версій, логи та вимірювання конверсій. Це можна реалізувати в межах продуктової розробки або підготовки ecommerce до агентної комерції. Надішліть нам домени й зони, які потрібно перевірити.
Що читати далі: пройдіть аудит готовності магазину до AI-покупців, а потім налаштуйте атрибуцію трафіку й продажів з AI-каналів.
Джерела й дата перевірки
Перевірено 20 серпня 2026 року за офіційною документацією краулерів OpenAI і FAQ для видавців; правилами Anthropic та Perplexity; новими рекомендаціями Google щодо генеративного пошуку й токена Google-Extended; Cloudflare AI Crawl Control; стандартом RFC 9309; і дослідженням McKinsey про AI у виборі товарів. Назви ботів і правила змінюються — перед релізом звірте актуальні сторінки провайдерів.